Een gaming-pc koop je tegenwoordig niet alleen meer voor hoge FPS. Met de opkomst van lokale kunstmatige intelligentie wordt je computer ook steeds interessanter als persoonlijke AI-assistent. Maar hoe weet je eigenlijk of jouw gaming-pc geschikt is voor AI? En hoe snel kan een taalmodel zoals Llama, Qwen, DeepSeek of gpt-oss antwoorden?
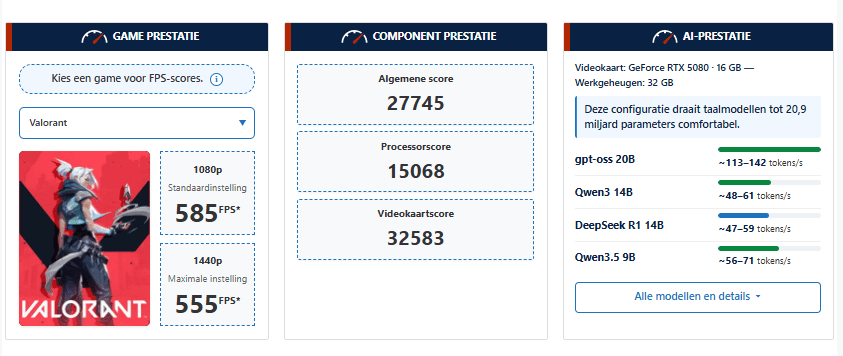
Bij Azoth Gaming maken we dat nu een stuk overzichtelijker. Naast de bekende gameprestaties en componentscores vind je bij geselecteerde gaming-pc’s ook een nieuwe functie: AI-PRESTATIE. Hiermee kun je zien welke taalmodellen je lokaal op een computer kunt uitvoeren, hoeveel videogeheugen daarvoor nodig is en hoeveel tokens per seconde het systeem naar verwachting kan genereren.
Zo vergelijk je gaming-pc’s niet langer alleen op FPS, maar ook op hun mogelijkheden voor AI.
Wat is de AI-PRESTATIE-functie?
De AI-PRESTATIE-functie geeft een overzicht van verschillende taalmodellen die je op een specifieke computer kunt draaien.
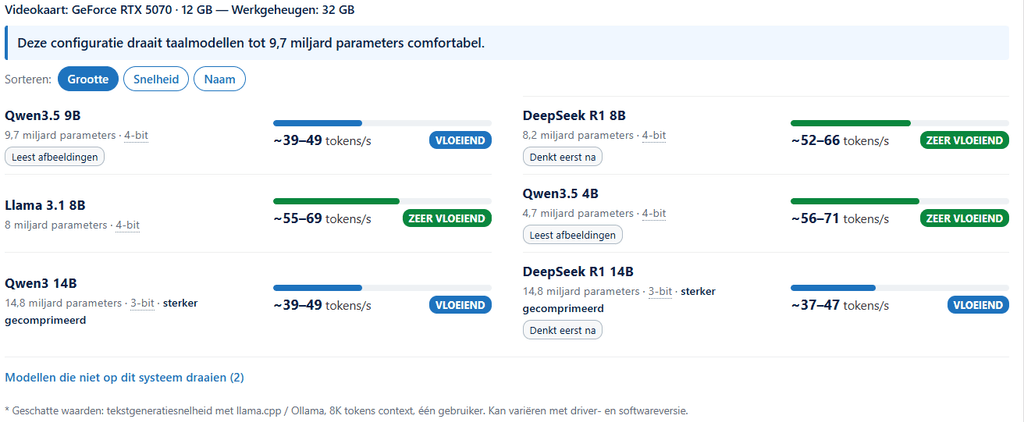
Bij ieder model zie je onder andere de geschatte antwoordsnelheid, het aantal parameters en eventuele bijzondere functies, zoals afbeeldingen begrijpen of extra redeneren voordat een antwoord wordt gegeven. Ook wordt rekening gehouden met de videokaart, de hoeveelheid VRAM en het werkgeheugen van de computer.
Dit is interessant voor iedereen die AI lokaal wil gebruiken, bijvoorbeeld om een eigen chatbot te draaien, ingewikkelde onderwerpen te begrijpen, teksten te schrijven of persoonlijke projecten uit te werken.
De AI-PRESTATIE-functie is een keuzehulp voor de hardware. De genoemde taalmodellen zijn niet automatisch voorgeïnstalleerd; daarvoor gebruik je geschikte software zoals LM Studio of Ollama.
Wat zijn tokens per seconde?
Wanneer je een vraag stelt aan een AI-taalmodel, verschijnt het antwoord meestal stukje voor stukje. Deze stukjes worden tokens genoemd. Een token is niet altijd een volledig woord. Het kan ook een deel van een woord, een leesteken of een andere kleine teksteenheid zijn. De snelheid waarmee een AI-model tekst genereert, wordt uitgedrukt in tokens per seconde (tokens/s). Hoe hoger dit getal, hoe sneller het antwoord op je scherm verschijnt.
| AI-snelheid | Wat merk je tijdens het gebruik? |
|---|---|
| 5 tokens/s | Antwoorden verschijnen langzaam |
| 10 tokens/s | Goed te volgen tijdens het lezen |
| 20 tokens/s | Comfortabel voor dagelijks gebruik |
| 30 tokens/s | Tekst verschijnt snel en vloeiend |
| 60 tokens/s | Zeer snelle tekstgeneratie |
| 100+ tokens/s | Uitstekende snelheid voor intensief gebruik |
Stel dat een AI-model een antwoord van 150 tokens moet schrijven. Bij 10 tokens/s duurt het genereren ongeveer 15 seconden, terwijl dit bij 30 tokens/s ongeveer 5 seconden duurt. Dit is exclusief de verwerkingstijd vóór het eerste token. Bij een complexe vraag of een model dat eerst redeneert, kan het dus langer duren voordat het antwoord begint te verschijnen.
Wat betekenen ‘Leest afbeeldingen’ en ‘Denkt eerst na’?
In onze AI-PRESTATIE vergelijking kom je verschillende labels tegen. Hiermee zie je welke extra mogelijkheden een taalmodel biedt.
Leest afbeeldingen
Een model met het label ‘Leest afbeeldingen’ kan naast tekst ook visuele informatie verwerken. Je kunt zo’n model bijvoorbeeld een afbeelding laten beschrijven, informatie uit een screenshot laten halen of vragen stellen over wat er op een foto te zien is. Voor de vision-modellen in onze vergelijking wordt een aanvullende component van ongeveer 1GB gebruikt. Daarvoor moet dus ook voldoende videogeheugen beschikbaar zijn.
Denkt eerst na
Sommige modellen zijn ontwikkeld om complexere vragen met aanvullende redeneerstappen te behandelen. Deze modellen krijgen het label ‘Denkt eerst na’. Denk aan moeilijke rekenvragen, programmeerproblemen of opdrachten waarbij meerdere stappen nodig zijn. Omdat het model eerst extra verwerking uitvoert, kan het langer duren voordat het uiteindelijke antwoord zichtbaar wordt. Een hogere tokensnelheid betekent daarom niet automatisch dat het antwoord bij iedere vraag eerder begint.
Waarom zijn 8GB en 16GB VRAM zo belangrijk?
Voor gaming wordt de hoeveelheid VRAM vaak besproken vanwege textures, resolutie en grafische instellingen. Maar bij lokale AI speelt videogeheugen een minstens zo belangrijke rol. Wanneer je een AI-model uitvoert, moeten de modelgegevens zoveel mogelijk in het geheugen van de videokaart passen.
Een videokaart met 8GB VRAM kan al verschillende compacte taalmodellen uitvoeren. Met 16GB VRAM krijg je meer ruimte voor grotere modellen en complexere toepassingen. Dat betekent niet dat een videokaart met 16GB automatisch twee keer zo snel is als een kaart met 8GB. Het grootste voordeel is dat je grotere AI-modellen kunt gebruiken die anders niet volledig binnen het beschikbare videogeheugen passen. De hoeveelheid systeem-RAM en de instellingen van het model spelen eveneens een rol.
Echte voorbeelden uit onze AI-PRESTATIE vergelijking
Om het verschil duidelijk te maken, kijken we naar drie gaming-pc-configuraties die op Azoth Gaming worden aangeboden.
| Gaming-pc | Lokaal AI-model | Geschatte snelheid |
|---|---|---|
| ELITE-5060Ti – RTX 5060 Ti 8GB | Llama 3.1 8B | 39–49 tokens/s |
| GAMING-DUAL5060Ti – RTX 5060 Ti 16GB | gpt-oss 20B | 60–76 tokens/s |
| VULCAN-5080 – RTX 5080 16GB | gpt-oss 20B | 113–142 tokens/s |
Bron: AI-PRESTATIE-overzichten op Azoth Gaming. Het gaat om geschatte tekstgeneratiesnelheden bij één gebruiker, een context van 8K tokens en gebruik van llama.cpp/Ollama. De werkelijke snelheid kan verschillen per software- en driverconfiguratie.
De vergelijking laat twee belangrijke zaken zien. Allereerst kan een RTX 5060 Ti met 8GB al een bruikbare basis zijn voor kleinere lokale taalmodellen. Met de RTX 5060 Ti 16GB wordt het mogelijk om ook grotere modellen zoals gpt-oss 20B binnen de opgegeven configuratie te gebruiken.
De RTX 5080 beschikt eveneens over 16GB VRAM, maar heeft meer rekenkracht en geheugenbandbreedte. Daardoor wordt voor hetzelfde gpt-oss 20B-model een aanzienlijk hogere antwoordsnelheid geschat. Het gaat dus niet alleen om hoeveel VRAM je hebt, maar ook om hoe snel de videokaart het gekozen model kan verwerken.
Wat betekenen 8B, 14B en 20B bij AI-modellen?
Naast de snelheid zie je bij veel taalmodellen een aanduiding zoals 8B, 14B of 20B.
De letter B staat voor billion, oftewel miljard. Deze aanduiding verwijst naar het aantal parameters van een model.
Een 8B-model beschikt dus over ongeveer acht miljard parameters. Grotere modellen hebben vaak meer mogelijkheden om complexe vragen te behandelen, maar vragen doorgaans ook meer geheugen en rekenkracht. Dat betekent niet dat een groter model altijd beter is. De kwaliteit hangt ook af van de training, architectuur en het soort opdracht.
Daarnaast zie je soms termen zoals 4-bit of Q4_K_M. Dit zijn vormen van quantisatie, waarbij modelgegevens compacter worden opgeslagen zodat ze minder geheugen gebruiken. Hierdoor kunnen grotere modellen op een gewone gaming-pc draaien, al kan sterkere compressie invloed hebben op de kwaliteit.
Sommige modellen, zoals gpt-oss 20B, gebruiken bovendien een Mixture-of-Experts-architectuur. Daarbij wordt per token slechts een deel van het totale model actief gebruikt, wat efficiëntere verwerking mogelijk maakt.
Wat kun je thuis met zulke lokale AI-modellen doen?
Het mooie aan lokale AI is dat je zelf kunt experimenteren met verschillende modellen en toepassingen. Je kunt bijvoorbeeld een eigen AI-chatbot opzetten die helpt bij het schrijven van teksten, het begrijpen van programmeercode of het uitwerken van ideeën. Met geschikte software kun je ook documenten laten samenvatten of afbeeldingen analyseren wanneer het gekozen model dat ondersteunt. Een belangrijk voordeel is dat lokaal uitgevoerde modellen niet standaard een externe AI-server nodig hebben. Programma’s zoals LM Studio ondersteunen zelfs volledig offline chatten met vooraf gedownloade modellen.
Dat geeft je meer controle over persoonlijke informatie en de mogelijkheid om zonder internetverbinding AI te gebruiken. De mogelijkheden blijven wel afhankelijk van de gebruikte software, modellicentie en hardware.
Hoe kies je een gaming-pc voor AI?
Wil je vooral gamen en af en toe een kleine lokale chatbot gebruiken? Dan kan een videokaart met 8GB VRAM al voldoende zijn. Wil je vaker experimenteren met grotere taalmodellen, afbeeldingen laten analyseren of uitgebreidere AI-projecten uitvoeren? Dan is een gaming-pc met 16GB VRAM een interessante keuze. Ben je van plan intensief met AI te werken en wil je dat tekst zo snel mogelijk verschijnt, dan is het belangrijk om naast VRAM ook naar de daadwerkelijke GPU-prestaties te kijken.
Met onze AI-PRESTATIE vergelijking kun je deze verschillen gemakkelijker beoordelen, zonder zelf alle technische specificaties en modelvereisten te hoeven onderzoeken.
Conclusie: vergelijk je volgende gaming-pc ook op AI-prestaties
Een moderne gaming-pc kan veel meer dan alleen games draaien. Met geschikte hardware kun je je eigen AI-modellen lokaal gebruiken, een persoonlijke chatbot opzetten en experimenteren met nieuwe toepassingen van kunstmatige intelligentie. Met de nieuwe AI-PRESTATIE-functie van Azoth Gaming zie je welke modellen bij een gaming-pc passen en hoe snel ze naar verwachting antwoorden. Van compacte 8B-modellen tot krachtigere 20B-modellen: de combinatie van GPU-rekenkracht, VRAM en het gekozen taalmodel bepaalt je ervaring.
Benieuwd hoe krachtig jouw volgende gaming-pc is voor AI? Bekijk dan onze gaming-pc’s bij Azoth Gaming, open een productpagina en ontdek onder AI-PRESTATIE welke taalmodellen je lokaal kunt draaien.
Zo kies je niet alleen een gaming-pc voor de games van vandaag, maar ook voor de AI-mogelijkheden van morgen.